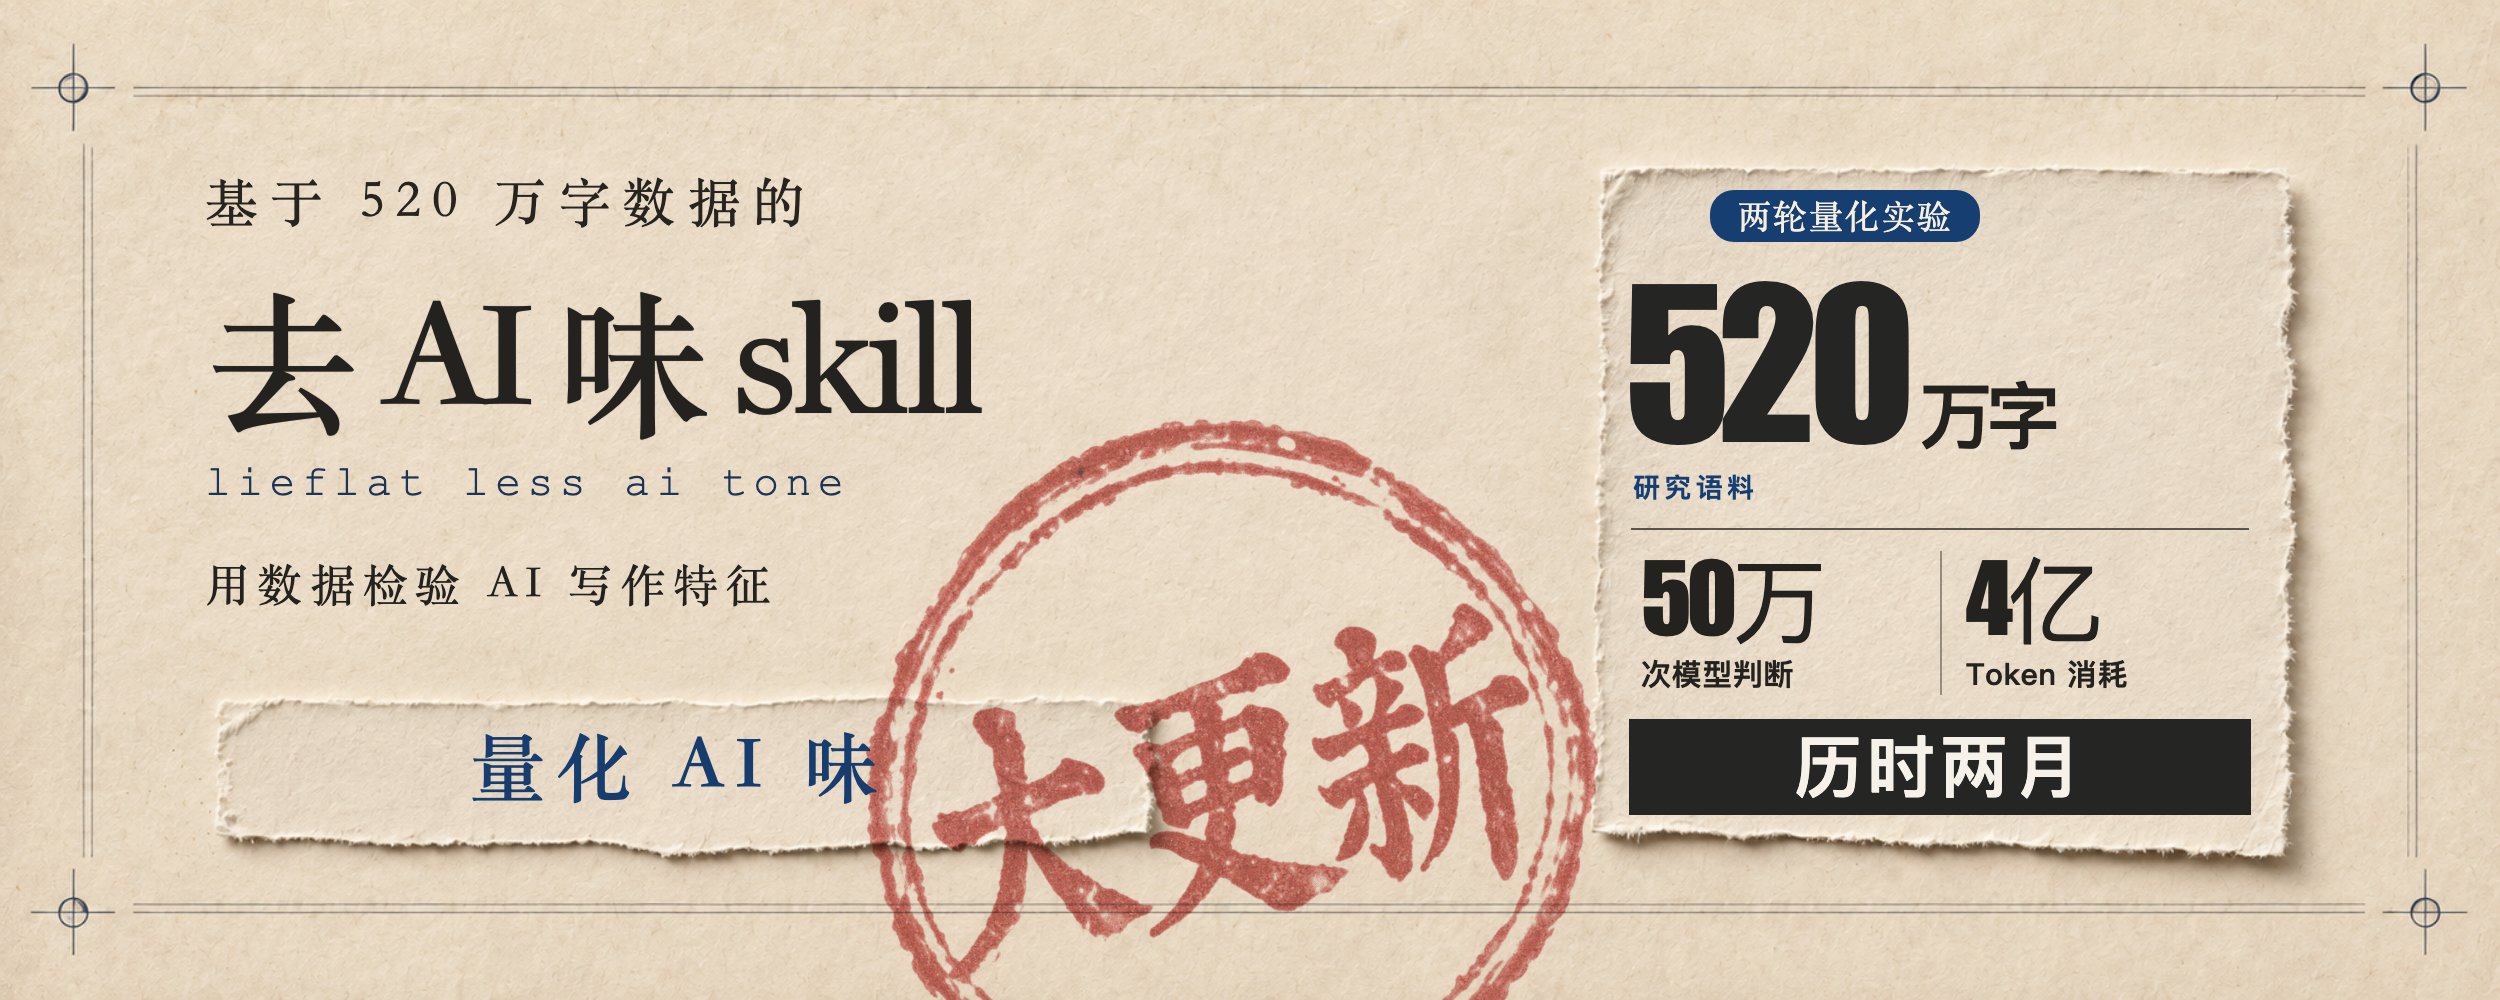
跑完520万字和50万次判断,我做了可能是全网最硬核的「去AI味」Skill。
2026 年 11 月 10 日 · admin
今天这篇可能会稍微硬核一点。
但是,如果你平时用 AI 写东西,这篇能帮你省下很多改稿到崩溃的时间。
过去两个月,我一直在做一个语言学实验。
我做了两轮数据实验来量化“什么是 AI 味”,第一轮 629 篇文章(283 万字),第二轮新跑了 540 篇配对文章(256 万字),前后折腾了 1169 篇文章,一共 520 万汉字。
基于这 520 万字语料,我把市面上能想到的“AI 味”拆成了 100 多项指标,用脚本检测、大模型语义检测和人工盲评三种方式检验,跑了 50.7 万次逐句逐段的机器语义判断,最后自己还把抽出来的候选句和比喻人肉盲读了一遍。
在这个实测数据的底子上,我做成了现在的 lieflat-less-ai-tone 这个skill,目前已经全部开源:https://github.com/larashero3-dotcom/lieflat-less-ai-tone
今天我就用大白话跟大家聊聊:真正的 AI 味到底是什么,以及这个 Skill 是怎么把它量化测评的。
历时两月,我做了两轮量化实验,烧了 4 亿 token
先简单说说我是怎么测的。
我的核心思路是,“AI 味”其实就是 AI 的写作习惯,所以我选择优秀的人类真实文章作为基准,和 AI 生成的文章进行对照测评,差异的部分,就可以称之为“AI味”。
其实我在做第一版的时候,已经让 5 个主流模型(Claude Opus 4.6、GPT-5.6、DeepSeek、Gemini、Kimi)写了 300 篇文章,跟 329 篇人类文章做过一次对比了。
但跑完第一轮,我发现了一个致命漏洞。
两边写的根本不是同一篇东西。
比如说,人类那篇写的是某家公司的财报,里面全是数字,但是AI 写的是行业趋势漫谈,里面没几个数字。这时候你跑脚本算出来“人类的数字密度是 AI 的 3 倍”,这能说明 AI 不爱用数字吗?不能,这纯粹是因为题目不一样。
因为我测评的目标,是量化 AI 的写作风格,所以我并不需要衡量信
解锁完整内容
有效会员可阅读全部付费资源,也可按本篇设置单独购买。
单篇购买 ¥ 9.90
交流与讨论